AI算力持续扩张,高端PCB凭什么成为关键一环?丨算力筑基·板载未来论坛圆满落幕
2026年的今天,行业在谈论AI服务器性能时,焦点往往还是GPU算力指标。但当越来越多GPU被装进服务器,一个更具体的问题也随之浮现,不同器件能否在场景中高效协同?整套系统又能否在高负载下稳定运行?
这些问题把大家的目光引向了芯片之外的硬件世界。PCB连接芯片、存储与网络,承担信号传输、供电和系统互联等任务;先进封装改变芯片的集成方式,板载存储影响数据供给效率,高速互联则决定算力能否在更大规模上协同。AI服务器的升级由此不再只是计算芯片的迭代,也在推动底层硬件架构重新调整,高端PCB的价值与技术门槛随之上升。
10月27日,由半导体行业观察主办的“算力筑基·板载未来——PCB赋能算力基础设施高质量发展论坛”在深圳国际会展中心(宝安)举行。来自产业研究、工业存储、AI云、先进封装与通信领域的嘉宾围绕算力基础设施展开讨论,从PCB切入,延伸至存储、封装与系统互联,探寻AI算力持续增长背后,硬件产业链正在发生的变化。
算力升级与硬件投资新机遇
论坛首先由摩元智库半导体产业资深分析师顾正书带来《算力重构,硬件筑基:AI浪潮下“PCB-存储-封测”三维协同的投资全景与本土破局》主题演讲。他将观察视角放在AI算力基础设施的整体演进上,分析计算、存储与互联之间的约束关系,以及这些变化如何重塑产业链的技术路线与投资机会。
顾正书指出,AI算力的增长正在遭遇越来越明显的物理限制。GPU计算能力持续提升,但数据传输速度、存储带宽与互联效率未必能够同步跟上。所谓“内存墙”和“互连墙”,反映的正是计算能力与数据供给、传输能力之间的失衡。随着这一矛盾加深,过去各环节相对独立的优化方式,正在向系统级协同设计转变。
根据顾正书演讲中的测算,全球AI相关PCB与封装载板产值预计将从2025年的91.77亿美元增长至2030年的484.05亿美元,五年复合增长率达到39.5%。其中,高阶HDI与超高层板的增长尤为突出,意味着AI服务器对高密度互联、复杂布线及高层数板卡的需求将持续提升。
他特别强调,高端PCB和封装载板的制造难度,体现在材料、设备、工艺与良率的综合约束上。高层板需要占用更多积层资源,大尺寸板件面临更严苛的平整度和贴合要求,高频材料也对钻孔、加工和信号完整性提出更高要求。厂房建成、设备到位,并不等于能够稳定交付符合客户标准的产品。
进一步看,PCB、存储与先进封装之间的边界也在变得更加紧密。HBM带来的高带宽需求推动封装互联向更精细的线宽线距发展,CXL等技术则对板级高速信号传输提出更严格的要求;大尺寸芯片与封装又增加了热应力、翘曲控制和供电设计的难度。
顾正书在最后总结道,产业竞争的关键,正逐步从单一环节的规格升级转向系统级交付能力。对国产企业而言,只有让材料、制造、封装与客户设计形成更紧密的协作,才能把技术进步真正转化为稳定的量产能力。
板载存储支撑高算力发展
如果说顾正书从产业全景解释了PCB、存储与封测协同升级的必要性,那么深圳佰维存储科技股份有限公司产品总监陈逸君,则将讨论进一步落到了数据供给这一具体环节。
在《聚力板载底层,构筑高算力时代的工业存储新范式》主题演讲中,陈逸君指出,工业场景正在经历由数据采集、机器视觉向生成式AI、智能体决策等应用形态的演进。随着工业AI深入生产流程,设备传感器、视觉系统、工业仿真和多设备协同产生的数据持续增加,存储系统承担的任务也随之改变。
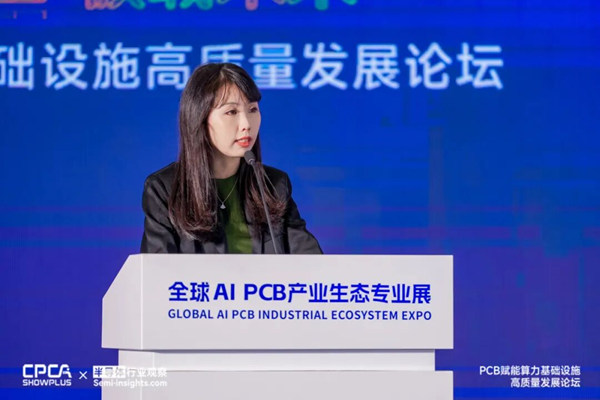
传统工业存储更关注容量、寿命与稳定性,而当边缘AI、机器视觉和智能控制逐渐普及,存储还需要满足更高的数据吞吐、并发访问和实时响应要求。模型参数、推理缓存与实时采集数据同时运行,对存储带宽和时延提出了新的要求。如果数据无法及时供给计算单元,即使芯片具备足够的算力,也可能因为等待数据而无法充分发挥性能。
这一变化也让存储与PCB之间的协同更加重要。板载存储正朝着高密度、紧凑化方向发展,器件选型、接口设计、信号完整性和系统布局需要共同考虑。对于高算力工业设备而言,存储方案不能只看单个器件的峰值参数,还要关注它在真实工况下能否持续稳定运行,包括全盘写入时的性能表现、宽温循环后的性能变化,以及异常掉电时的数据完整性。
围绕这些需求,佰维持续布局存储主控、固件、封装制造与测试验证能力,并推出面向工业和汽车电子场景的佰维特存解决方案。陈逸君介绍,佰维通过自研固件、介质研究、主动防护和可靠性测试等方式,提升存储产品对复杂工况的适应能力。其工车规产品覆盖嵌入式存储、SSD、内存模组及存储卡等类型,并针对不同场景提供温度等级与定制化方案。
从更长的产业链来看,工业存储的价值正在从单一器件供应延伸到系统级适配。存储介质决定数据承载能力,主控与固件影响访问效率,封装与PCB则关系到器件如何融入整机。只有这些环节共同适应应用场景,存储才能真正成为高算力系统稳定运行的支撑,而非制约计算效率的短板。
AI服务器的硬件设计挑战
当算力从单台服务器走向大规模集群,产业面临的问题也随之变化。芯片性能再强,如果网络出现拥塞、存储供给不稳定,或者某个节点发生故障,都可能影响整个训练任务的执行效率。百度智能云泛科技业务解决方案总监张东锦在《万卡集群背后的硬功夫——百度智能云“芯-云-模-体”全栈AI云与半导体行业实践》主题演讲中,分享了大规模算力基础设施建设与长期运维的实践。
张东锦指出,十几张卡的集群与万卡级计算矩阵面临着完全不同的运维挑战。规模扩大后,硬件数量和系统耦合程度同步上升,静默数据错误、网络抖动、任务阻塞等问题的影响也会被放大。一次局部异常可能拖慢整个训练过程,甚至造成大量计算资源和训练时间的浪费。因此,万卡集群的核心要求已经超越单个器件的性能指标,延伸至系统的稳定性、故障感知能力和恢复效率。
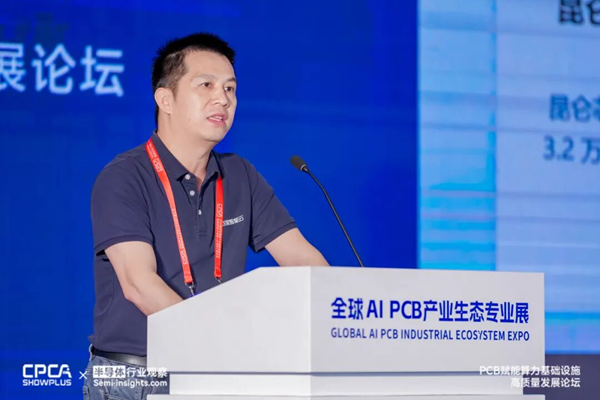
针对这些挑战,百度智能云以昆仑芯、AI基础设施和百舸AI计算平台构成算力底座,并通过调度、通信优化、故障感知与自动容错等软件能力,支撑大规模集群运行。张东锦介绍,百度智能云的相关实践覆盖集群创建、模型训练、推理部署与日常运维,目标是在复杂硬件环境下提高有效训练时长,并缩短故障恢复时间。其演讲材料显示,相关万卡集群有效训练时长占比达到99.5%,体现了软件管理与全栈协同对于规模化算力的重要性。
不过,软件能够管理和缓解故障,并不意味着底层硬件可以降低标准。高负载云机房通常需要长期连续运行,同时面临高温、大电流冲击、高密度部署和复杂散热条件。PCB必须兼顾高速信号完整性、低损耗与热循环可靠性;存储模组需要保障数据读写和长期耐久;封测成品则要控制良率、批次一致性与互联可靠性。任何一个环节的稳定性不足,都可能在大规模集群中被放大。
张东锦强调,百度在整机柜服务器、供电、散热和接口等方面持续推进标准化,希望降低批量采购、交付和运维的复杂度。以X-MAN等AI服务器平台为例,标准化设计能够为不同硬件配置提供更统一的集成基础,也有助于适配多样化AI芯片。对于PCB、存储和封测厂商而言,这意味着产品开发需要更早对接整机架构和客户标准,从设计阶段就考虑实际部署环境,而不是等到产品完成后再进行单独适配。
从百度智能云的实践可以看到,算力基础设施的竞争已经进入系统工程阶段。芯片决定计算能力的基础,PCB、存储与封装影响硬件协同效率,软件平台则负责调度和管理这些资源。随着集群规模扩大,底层硬件的稳定性与标准化程度,将越来越直接地影响算力资源的利用效率和整体运营成本。
先进封装与高速互联演进
随着计算芯片面积、功耗与数据带宽持续增长,单纯依靠传统芯片设计和板级布线,越来越难以满足下一代算力系统的需求。齐力半导体(绍兴)有限公司TPM总监汤尔昌在《从Chiplet到CPO:AI算力驱动下的先进封装与光电异质集成》主题演讲中,进一步将视角推进至芯片集成、封装互联与光电协同的技术前沿。
汤尔昌指出,AI产业的挑战不仅来自算力需求增长,也来自数据搬运所消耗的时间和能量。计算性能持续提升,但存储带宽和互联能力的增长相对滞后,数据传输逐渐成为系统效率的重要约束。与此同时,AI芯片功耗不断提高,热量集中、供电路径损耗和散热难度也在增加。如何在提升带宽的同时控制功耗、温度与成本,已成为芯片、封装和系统设计共同面对的问题。
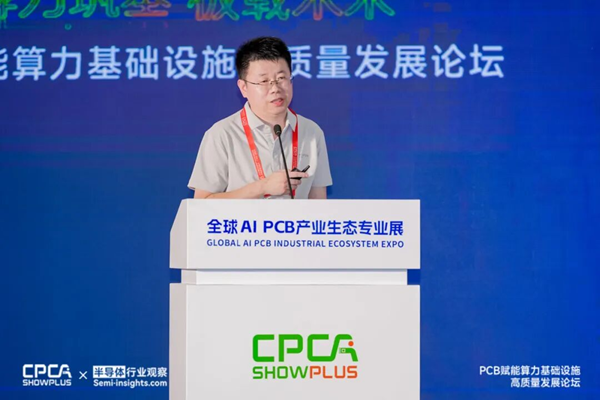
Chiplet是产业应对这些挑战的重要技术路线之一。通过将不同功能的芯粒集成在同一封装中,设计者可以突破单一芯片在面积、工艺和功能集成上的部分限制,并结合HBM等高带宽存储提升数据交换效率。但随着芯粒数量增加、互连密度提高,封装面临的热应力、翘曲、信号完整性和电源完整性问题也更加复杂。先进封装不再只是芯片的物理承载结构,而是直接参与系统性能设计的重要环节。
在光互联方向,汤尔昌重点介绍了从可插拔光模块到板上光学、近封装光学,再到共封装光学(CPO)的技术演进。随着高速电信号传输距离和速率不断提高,电互连的损耗与能耗压力逐渐上升,将光引擎进一步靠近计算或交换芯片,成为提升带宽密度、降低互联能耗的探索方向。CPO通过缩短芯片与光学器件之间的电气链路,为更高带宽的系统设计提供了新的可能。
他还展示了齐力半导体的815 mm²超大GPU 3D-Chiplet封装项目,该项目采用第二代高算力GPU封装方案,集成1962颗高密度微型Bump,对封装结构、电气性能和热应力控制提出了很高要求。为此,齐力将封装设计提前至芯片设计阶段,通过芯片、封装与系统协同设计,对近2000个Bump的电源分布和热应力进行预判,并结合Die区域及整体封装的翘曲仿真与实测结果进行验证,最终实现规模化量产。
这一案例背后,是齐力建立的全物理域仿真能力。从芯片、封装到系统的热仿真,到信号与电源完整性分析、应力翘曲预测,再到模流、光学和可靠性仿真,公司尝试将多种物理因素纳入统一的工程验证流程。仿真结果与实测相互校验,不仅有助于提前识别设计风险,也为封装良率和产品可靠性提供支撑。
汤尔昌在最后强调,通过在设计阶段同步考虑芯片、封装与系统需求,并对温度分布、应力、翘曲和信号传输进行联合分析,可以更早发现潜在问题,为产品良率和规模化生产提供支撑。对于PCB产业而言,这些变化意味着板级互联与封装载板需要更早参与系统协同设计,材料、线宽线距、热膨胀特性与制造精度都将成为影响最终性能的重要因素。
从硬件性能到集群稳定性
如果说先进封装解决的是芯片内部及近距离互联效率问题,那么当算力进一步扩展到跨机柜、跨数据中心乃至跨区域协同,网络基础设施就成为连接计算资源的另一条关键链路。中国联通国际有限公司销售总监杨程在《筑牢算力通信强底座,赋能AI时代新征程》主题演讲中,从运营商视角介绍了AI时代的算力通信基础设施布局。
杨程指出,AI大模型训练与推理对算力、数据和网络提出了更高要求。随着应用从模型调用向智能体执行演进,基础设施不仅需要提供充足的计算资源,还需要保障数据在不同节点之间高效流动,并支持算力、网络和云平台的协同调度。网络的角色也因此从基础连接逐渐延伸至算力资源组织与服务交付。
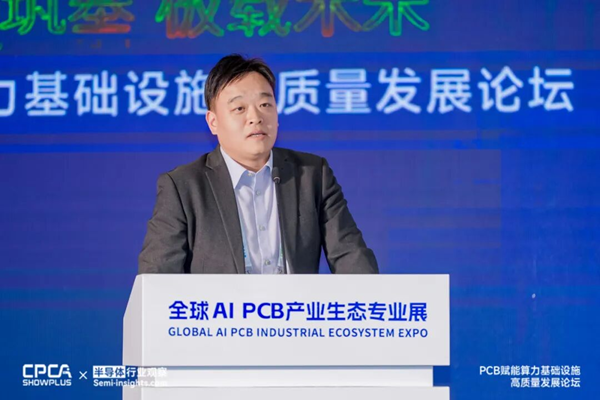
围绕这一需求,中国联通持续推进高速光网、5G-A及面向未来的6G技术布局,并建设覆盖国家、区域、省级及边缘节点的智算体系。杨程在演讲中介绍,中国联通通过“4+4+31+X+O”智算体系组织算力资源,并布局AINet算力智联网,探索应用、网络与算力之间的全域感知和智能调度。其目标是让分布在不同区域的算力资源能够更灵活地协同,为大模型训练、推理和行业应用提供基础支撑。
在AI平台层面,中国联通通过“九天”AI平台与“元景”大模型矩阵,覆盖数据治理、模型训练、应用开发与部署等环节,并进一步探索模型即服务和智能体平台。杨程介绍,相关平台希望降低企业调用和部署AI能力的门槛,推动模型能力向制造、医疗、政务等具体场景延伸。与此同时,网络基础设施也需要满足低时延、高可靠和安全合规等要求,使数据、模型与应用能够在复杂环境中稳定运行。
值得关注的是,中国联通在工业互联网、智慧医疗和智慧城市等领域不断探索AI应用,例如通过5G与AI视觉质检提升制造环节的检测效率,利用网络和智能诊断能力支持设备预测性维护。这些场景说明,AI基础设施的建设不仅是增加算力供给,还需要把计算、数据、网络与业务流程连接起来,形成可以持续运行的应用体系。
当算力资源跨越单机、机柜和数据中心,网络与板级互联的重要性也会进一步凸显。服务器内部需要PCB承载高速信号和稳定供电,节点之间需要高速网络实现数据交换,跨区域算力调度则依赖更广泛的通信基础设施。杨程的分享将论坛讨论延伸到了更广的系统范围:算力基础设施要真正释放价值,必须让每一层连接都能够适应整体系统的需求。
写在最后
从顾正书对产业格局的分析,到佰维对工业存储的探讨,再到百度云分享万卡集群运维实践、齐力半导体的先进封装与光电集成,以及联通的算力通信基础设施,不同企业关键技术分享共同勾勒出了AI算力产业链的演进方向。
算力升级正在改变硬件之间的关系。存储需要跟上数据吞吐与实时性要求,先进封装需要处理更高密度互联带来的热、电、力耦合问题,云平台需要保障大规模集群稳定运行,通信网络则要让分散的计算资源高效协同。PCB贯穿其中,既承担高速信号传输与电源分配任务,也需要与芯片、存储、封装及整机架构共同设计。
这也意味着,高端PCB的竞争将越来越取决于综合能力。低损耗材料、高层数制造、精密加工和可靠性控制仍是基础,但从设计协同、工艺适配到客户认证与稳定交付,每一个环节都影响着技术能否转化为实际价值。市场需求可以迅速升温,真正形成竞争壁垒的,却是持续满足复杂算力系统要求的能力。
对于国产产业链而言,AI算力带来的机会不止于市场规模扩大,更在于通过与存储、先进封装、服务器及云平台的深度协作,逐步建立系统级设计和交付能力。当连接不再只是硬件之间的物理通路,而成为决定算力效率、可靠性与成本的重要因素,PCB的产业价值也将随之提升。筑牢算力基础设施,需要的不仅是一块更高阶的电路板,更是一条能够共同演进、协同交付的产业链。